第6讲:社会网络中的社区识别与信息传播
数据科学与大数据技术专业,计算广告专业 · 大三上, 新闻与舆情数据学, 2026
← 返回课程主页 · 上一讲:文本分析建模 · 下一讲:研究设计与模型评测
新闻与舆情数据学课程讲义。承接第5讲文本建模。基础部分要求理解、计算和解释,拓展部分供课程项目选用。案例和计算数据均为虚构教学示例,不代表实际舆情结论。
一、本讲定位与学习目标
文本分析回答“人们谈论什么”,社会网络分析回答“谁与谁发生联系,内容沿哪些关系流动”。社区识别进一步把个体连接组织为中观结构,信息传播研究则引入时间和行为,考察内容如何进入、穿过或停留在这些结构中。
完成本讲后,应能:
- 根据研究问题定义节点、边、方向、权重与时间窗。
- 区分文本簇、结构社区、现实群体与立场群体。
- 解释GN、模块度优化、标签传播与重叠社区发现的思想。
- 计算基础网络指标,并判断指标支持什么结论。
- 理解SI、SIS、SIR、独立级联与阈值模型的假设。
- 区分链接预测、扩散预测与因果影响,完成带证据边界的传播分析。
1.1 贯穿案例:校园食堂服务调整
沿用第5讲案例。学校调整价格和营业时间,学生、校园媒体和校方账号发布信息。一部分讨论集中于价格,另一部分集中于夜间服务;校园媒体转载学生诉求,校方随后发布说明。
研究问题可以分为三个层次:哪些账号形成频繁互动的结构社区;价格议题怎样跨社区传播;说明发布后,各社区的诉求和互动结构怎样变化。前两个问题需要关系和时间数据,最后一个还需要可靠的内容编码。
只有评论正文而没有互动记录时,可以分析文本议题,但不能声称重建了真实转发路径。
二、把舆情问题转成网络
2.1 节点与边不是天然存在的
图记为  。节点集合V和边集合E由研究者依据问题定义。带时间的互动记录可以写为
 ,分别表示来源节点、目标节点、时间、关系类型和权重。
| 网络类型 | 节点 | 边 | 能够支持的解释 |
|---|---|---|---|
| 转发网络 | 账号或帖子 | 明确记录的转发 | 观察到的转载关系 |
| 回复网络 | 账号 | 回复行为 | 讨论与互动结构 |
| 关注网络 | 账号 | 关注行为 | 潜在接触关系,不代表实际曝光 |
| 实体共现网络 | 机构、人物等 | 同一文本或句子中共现 | 报道中的关联呈现 |
| 文本相似网络 | 文档 | 相似度超过阈值 | 内容相近,不能直接推断互相转载 |
| 用户—话题二部网络 | 用户和话题两类节点 | 用户参与话题 | 参与结构及议题交叉 |
账号A转发账号B的内容,有两种常见方向约定:行为网络记作A→B;内容流动网络记作B→A。本讲的传播网络统一使用“原作者→转发者”。研究者必须在图注中声明约定,否则入度和出度的解释可能完全相反。
2.2 数据表与治理
建议保留两张表:帖子表包含post_id、author_id、created_at、text、platform、source_url;互动表包含interaction_id、source_id、target_id、relation、event_time、parent_post_id和证据来源。另行记录采集时间,避免把它当作发布时间。
建图前处理重复采集、缺失主体、时区不一致和账号更名;同一真实互动的重复采集只计一次,不同时间发生的真实互动可以累加。自环、孤立节点和缺失父帖均应有明确处理规则。匿名化账号时仍需保留稳定映射。
回复不代表赞同,转发也可能包含批评。互动类型与态度标签必须分别保存。跨平台账号只有在具备可靠对应证据时才能合并;同名不是充分证据。
2.3 加权、多层与动态网络
同一对账号发生5次互动,可以设权重为5。也可以按不同互动类型分层,而不把回复、提及和转发全部混成一种关系。
时间窗决定网络的意义。全事件网络适合描述总体结构,按天或阶段构建的快照适合比较演化。比较时应说明节点全集是否固定、窗口长度是否相同以及活跃用户是否变化。社区编号每次运行都可能改变,不能把两期的“社区1”直接视作同一群体。
三、网络结构与关键节点
3.1 度、强度与密度
无向节点的度是邻居数;有向网络分别有入度和出度;强度是相连边权之和。按本讲内容流动方向,出度高表示内容被更多不同账号直接转发,入度高表示该账号转发了更多不同来源。两者都不等于说服效果。
简单无向图的密度为 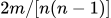 ,不含自环的简单有向图为
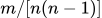 。密度取决于规模、边定义和采样,不能只凭密度上升就判断群体关系更紧密。
3.2 中介与接近中心性
节点中介中心性的未归一化形式为:
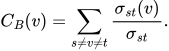
其中  是s到t的最短路径数,
 是经过v的路径数。高值意味着节点处于较多最短路径上,但信息未必沿最短路径传播,平台推荐也可能绕过可见关系。
接近中心性通常基于到其他节点的距离。非连通图应报告连通性,选择适当修正或调和中心性,并说明有向距离考察的是到达别人还是被别人到达。
互动频次越高表示关系越强,但最短路径算法中的权重通常表示距离或成本。不能直接把互动频次当作距离;若采用  ,必须说明这是分析假设,并与不加权结果比较。
3.3 三种“重要性”
结构重要性是节点在图中的位置,传播重要性是节点与观察到的扩散有关,社会影响是节点导致他人态度或行为改变。三者需要不同证据。中心性排序可以产生待核查名单,不能自动产生“意见领袖排行榜”。
四、社区的定义与计算示例
4.1 社区与内容簇
结构社区通常指内部连接相对密集、外部联系相对稀疏的节点集合。文本簇依据语义或词项相似度形成,两者可能交叉:同一社区讨论多个议题,同一议题也可能穿过多个社区。
强社区要求每个节点的内部度大于外部度;弱社区要求社区内节点的内部度之和大于外部度之和。它们是特定结构定义,并非所有算法都强制满足。现实网络还可能存在重叠成员、多层关系和随时间变化的边界。
4.2 模块度:比随机连接多出多少内部连接
简单无向图的模块度为:
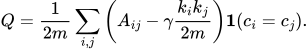
A是邻接矩阵,k是度,m是边数,c是社区归属,γ是分辨率参数。度保持的空模型提供内部连接的期望值。加权图用强度和总权重替代相应量;有向图应采用有向公式,不能机械套用上式。
取γ=1时,也可写为 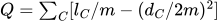 ,其中l是社区内部边数,d是该社区节点的度之和。
教学网络有两个三角形ABC、DEF,并以C—D连接。共6个节点、7条边。划分为{A,B,C}与{D,E,F}时,每个社区内部有3条边、度之和为7,因此:
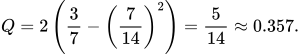
把所有节点放入同一社区时,γ=1下Q=0。这个例子说明该划分比空模型有更多内部连接,不说明两个社区具有不同立场。
五、主要社区识别方法
| 方法 | 核心思想 | 优点 | 主要限制 |
|---|---|---|---|
| Girvan–Newman(GN) | 逐步移除高边中介边 | 小图上直观,能展示分裂过程 | 重算开销大,分裂层数需选择 |
| Louvain | 局部移动提高模块度,再聚合社区 | 适合较大网络 | 随机性、分辨率限制,可能产生连接不良的社区 |
| Leiden(拓展) | 在优化中加入社区细化 | 改善社区连接性质 | 仍需选择目标函数与分辨率 |
| 标签传播 | 节点反复采用邻居中占优势的标签 | 实现简洁、通常运行较快 | 顺序和随机性影响结果,可能形成巨大社区 |
| 随机游走类 | 利用游走更易滞留在密集区域 | 可表达局部流动结构 | 具体目标与参数依算法而异 |
| 团渗透CPM | 连接共享k−1个节点的k团 | 允许节点多重归属 | 对稀疏图和k的选择敏感,可能遗漏节点 |
5.1 GN的操作过程
先计算所有边的中介中心性,删除最大的一条或一组,重新计算,再继续分裂。每次删除后重算很关键,因为路径结构已经改变。边中介不是节点中介;算法删除的是分析副本中的边,不是认定现实中应切断该联系。
在双三角形例子中,C—D是唯一连接两个部分的边。删除它即可形成两个连通分量。真实图中,高中介边也可能位于同一大社区内部,不能保证每次切分都有社会意义。
5.2 Louvain与分辨率
从节点各自成社区开始,尝试把节点移到邻居社区,保留提高模块度的移动;再将社区聚合成新图并重复。它是启发式优化,不保证全局最优。原课件提到的BGLL通常指这一方法,不应把它简单归为标签传播的改进。
较高γ通常倾向更细的划分,较低γ通常倾向更粗的划分,但具体结果还受优化过程影响。选γ的目的应是检查研究结论在不同尺度是否成立,不是调出预期的群体数量。
5.3 重叠与动态社区
桥接节点不自动属于两个社区;非重叠算法仍会把它归到一个集合。若研究“同时参与多个讨论圈”,应选择重叠方法或直接统计用户参与的多个话题,明确成员资格的含义。
动态分析可用相邻时间窗的成员交集、Jaccard相似度 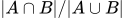 辅助匹配社区,并允许分裂、合并和新生。不要强行给每一期社区找一一对应关系。
六、社区结果怎样评估和命名
有可信参考划分时,可以使用NMI、ARI;重叠划分需选择适合多重成员资格的指标,例如Omega。组织标签或学院标签是外部属性,未必是互动社区的“真值”。
没有参考划分时,应联合检查模块度、规模分布、内部连通性、跨社区边、不同随机种子的一致性及代表内容。高模块度不能单独证明质量,更不能用于不加说明地比较不同图和不同γ。
建议每个主要社区抽查中心节点、普通成员和边界成员,并保存原文证据。初始命名用“社区A”“社区B”,核验后可写“以价格诉求讨论为主的社区”,避免使用无身份依据的“激进群体”“水军组织”等名称。
结构相似可能来自同质性选择、共同接触来源、平台推荐或社会影响。仅凭相邻账号表达相似,不能区分这些机制,也不能证明协同行动。
6.1 文献综述:结构识别与社会解释之间的距离
Girvan与Newman(2002)将社区结构理解为内部连接紧密、群组之间联系较疏的结构,并以中心性识别社区边界,在已知与未知结构的网络上进行验证。这项工作为GN算法提供依据,但验证的是关系图的划分,不是节点的政治立场、真实组织身份或协同行为。原始论文
从这一研究出发,课程项目需要分两步:先检查结构结果是否稳定,再用独立属性、内容与行为证据解释群组。两步使用不同证据;算法标签只是待解释对象。因而“社区A中多数样本讨论价格”可以是有编码依据的描述,“社区A是某组织成员”则需要身份材料,不能从同一划分直接推出。
七、从静态关系到传播过程
7.1 时间约束与传播级联
静态图中的A→B→C只表示存在两条边。如果B→C早于A→B,路径就不能解释这条信息按该顺序传播。传播路径应同时符合关系类型、内容关联和时间顺序。
有明确父帖记录时,可构建传播级联;父帖缺失时,应标注不完整,不能仅凭发布时间把所有帖子接到最早节点上。“首次观察到的发布者”也不等于整个互联网的首发者。
| 指标 | 定义 | 解释边界 |
|---|---|---|
| 级联规模 | 按既定单位统计的传播节点数 | 帖子数与去重用户数分别报告 |
| 深度 | 从根到节点的最长路径长度 | 广播式传播可能规模大、深度小 |
| 最大宽度 | 某一传播层的最大节点数 | 不等于平台曝光人数 |
| 到达时间 | 从根发布到目标节点传播的时差 | 受时间精度和缺失记录影响 |
| 跨社区边比例 | 跨社区传播边数/可判定归属的传播边数 | 明确按唯一边还是互动次数计数 |
| 新参与用户数 | 窗口中首次观察参与的去重用户数 | 不等于首次接触事件的人数 |
跨社区边增多可以表示讨论外溢,也可能是对立群体互相批评。必须结合内容与态度解释。
7.2 弱关系与复杂传播
弱关系可能把内容带入新的圈子;强关系和重复接触可能支持需要信任或社会认可的行动。关系强度、跨社区位置和传播效果是不同概念。跨社区边未必是弱关系,同社区内部也可能意见分化。
7.3 文献综述:弱关系论证的适用条件
Granovetter(1973)讨论关系强度、局部关系与更大社会结构之间的联系,为理解信息如何穿过紧密圈子提供了经典视角。其论证并不是“所有弱关系都传播得更快”,也不是仅凭一条跨社区边就能够确认弱关系。原始论文
对舆情传播的应用应检验两类证据:关系强弱是否由互动历史等资料合理测量,相关内容是否确实沿该关系跨圈流动。若只有事件期边表,往往只能描述跨社区连接;关于弱关系机制的解释应保留为待验证推断,并同时考虑推荐、媒体转载与共同外部事件。
八、信息传播模型
8.1 SI、SIS、SIR与SIRS
| 模型 | 状态转移 | 信息传播中的教学解释 |
|---|---|---|
| SI | S→I | 尚未参与者开始传播,模型中持续活跃 |
| SIS | S→I→S | 活跃者停止后仍可能再次参与 |
| SIR | S→I→R | 活跃传播后退出,此次过程不再参与 |
| SIRS | S→I→R→S | 退出一段时间后再次具有参与可能 |
S、I、R是建模状态,不是人的价值分类;看到信息、相信信息、分享信息是不同状态,不能混用。SIR中的R在信息模型中可以表示停止传播,并不意味着已被纠正或形成免疫。
均匀混合的连续时间SIR可写为:
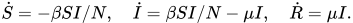
β和μ是速率,N=S+I+R。在这一模型及相应早期条件下,增长取决于 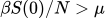 。不能把均匀混合模型的阈值直接视为任意网络的普遍阈值。网络结构、个体差异和外部输入都会改变传播过程。
8.2 独立级联(IC)
节点首次激活后,对每个尚未激活的出邻居尝试一次,以给定概率成功。失败后不再重复尝试该边,过程持续到没有新激活节点。
例如A激活后分别以0.2和0.5的概率尝试B、C。本轮新增激活数的期望为0.7,这不是整个级联的期望规模,因为后续还可能继续传播。概率需要数据估计或明确设为模拟参数,不能把互动频次直接解释为传播概率。
8.3 线性阈值(LT)
节点v具有阈值θ;入邻居的影响权重通常非负且总和不超过1。当已激活邻居的权重之和达到θ时,v激活。两个邻居各贡献0.3,θ=0.5时,单个邻居不足,二者共同激活则达到阈值。
IC表达一次尝试的随机扩散,LT表达累积影响。这是机制假设,不是证明现实分享行为必然符合某个模型。
8.4 影响力最大化与模拟评测
给定种子预算k,选择种子集合,使模型下预期激活规模最大。在特定渐进IC/LT模型及单调、次模等条件下,精确评估的贪心方法具有  近似保证;这不是“真实传播预测准确率至少63%”。有限模拟估计会带来额外误差。
课堂可以比较随机选种子、按度选种子和按中介选种子。每种策略应重复模拟,报告均值和离散程度。结论应写为“在本图与所设参数下”,不能推成现实干预效果。若要解释真实扩散,还需校准参数、检验样本外表现和加入平台推荐等竞争机制。
九、链接预测:预测关系,不等于预测态度
链接预测可用于推测缺失边或预测未来新增边。两种任务不同:前者研究观测不完整,后者研究时间演化。
无向简单图的基础相似性方法包括:共同邻居 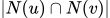 ;Jaccard相似度;Adamic–Adar得分
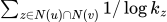 。它们体现相似性假设,有向转发网络需要重新定义邻居和候选方向。
未来预测必须在截止时间冻结图与特征,用之后的新增边评价。不能使用未来全图算中心性后再声称预测未来。候选负例应明确是否覆盖所有未连边对、是否只考虑活跃节点以及如何采样;没有观测到边不一定表示真实不存在。
稀疏网络可报告PR-AUC、Precision@K和Recall@K,并配合随机、度或共同邻居基线。ROC-AUC只能作为补充。链接预测得分未经校准通常不是概率,也不支持“某用户将相信某观点”的结论。
十、课堂实验:一份可运行的小网络
以下代码只构建无向教学图,以聚焦社区原理。正式项目的转发方向与权重需要另外保留。环境需要Python与NetworkX,记录实际安装版本。
import networkx as nx
from networkx.algorithms import community

G = nx.Graph()
G.add_edges_from([
    ('A', 'B'), ('B', 'C'), ('A', 'C'),
    ('D', 'E'), ('E', 'F'), ('D', 'F'), ('C', 'D')
])
partition = next(community.girvan_newman(G))
print('节点、边、密度:', len(G), G.number_of_edges(), nx.density(G))
print('社区:', [sorted(c) for c in partition])
print('模块度:', community.modularity(G, partition))
print('节点中介:', nx.betweenness_centrality(G))
print('边中介:', nx.edge_betweenness_centrality(G))

# 检查结论对额外跨社区关系是否敏感
H = G.copy()
H.add_edge('B', 'E')
p2 = next(community.girvan_newman(H))
print('修改后社区:', [sorted(c) for c in p2])
print('修改后模块度:', community.modularity(H, p2))
原图应得到6个节点、7条边,密度约0.467,首层GN划分为两个三角形,模块度约0.357。社区集合的输出顺序没有含义。
实验依次完成:画出原图并手算模块度;解释C、D的桥接位置;新增B—E并比较;将一个三角形解释为赞同者、反对者或同学院成员,讨论为什么同一图不能独立验证这些命名。
正式项目再完成:构建有向传播图;保留无向投影规则;比较至少两个参数或窗口;抽查社区内容;输出一张时间线和三条可追溯传播记录。无向投影适合部分社区算法,但会丢失传播方向,不能拿投影中的路径替代有向传播路径。
十一、自测题与答题要点
- 同一社区是否意味着相同立场?——不意味着,需独立内容编码与成员证据。
- 高中介账号是否控制了信息?——仅说明结构位置,真实传播和因果控制需更多证据。
- 为什么静态路径可能不是传播路径?——时间顺序、关系类型或内容关联可能不成立。
- 模块度高是否说明算法找到了真实组织?——只反映给定图和空模型下的结构性质。
- IC与LT的区别是什么?——前者一次随机尝试,后者累积影响达到阈值。
- 为什么不能用完整事件网络评估未来链接预测?——未来关系进入特征会造成信息泄漏。